

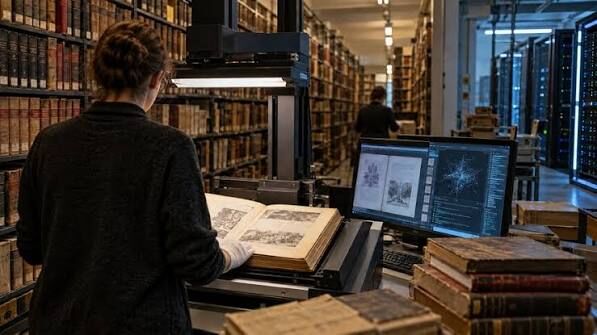
Argun'un aktardığına göre, Hollanda merkezli bir firma Nobel Akademik Yayıncılık'tan 3 binden fazla kitap için satın alma talebinde bulundu. Farklı yayınevlerinden de yaklaşık 2-3 bin kitabın talep edildiğini belirten Argun, kitapların çoğunun tek nüsha olarak istenmesinin şüphe oluşturduğunu söyledi. Taleplerin yapay zeka eğitimiyle bağlantılı olduğu kanaatine varılmasının ardından siparişlerin iptal edildiğini ifade etti.
Binlerce Kitap İçin Toplu Satın Alma Talepleri
Argun, yapay zeka şirketlerinin doğrudan yayınevleriyle iletişime geçmek yerine aracı kuruluşlar üzerinden veri ve içerik toplamaya çalışabildiğini öne sürdü. Söz konusu taleplerin yalnızca basılı kitaplarla sınırlı olmadığını belirten Argun, yayınevlerinin e-kitaplarını kiralayan dijital platformlara da benzer tekliflerin götürüldüğünü aktardı.
Bu platformlardaki dijital içeriklerin toplu şekilde satın alınmasına yönelik girişimlerin de bulunduğunu ifade eden Argun, yayınevlerinin içeriklerin hangi amaçla kullanılacağını ve telif haklarının nasıl korunacağını dikkate alarak karar vermesi gerektiğini söyledi.
Argun ayrıca, nadir eserlerin taranarak dijitalleştirildikten sonra fiziksel olarak imha edildiği veya kamu erişimine kapatıldığı yönündeki iddiaları gündeme getirdi. Bu uygulamaların gerçekleştiğine ilişkin somut örneklerin ayrıca doğrulanması gerektiğini belirten Argun, içeriklerin birkaç büyük teknoloji şirketinin kontrolünde toplanmasının yayıncılık açısından tekelleşme riski yaratabileceğini savundu.
Açık Erişim İle Yapay Zeka Eğitimi Ayrımı
Yapay zeka sistemlerinin akademik içerikleri kullanması, yayıncı açısından yalnızca ticari bir telif meselesi olarak değerlendirilmiyor. Argun, akademik yayıncılığın hakemlik, kaynak gösterme, atıf ve denetlenebilirlik ilkelerine dayandığını belirterek açık erişim ile yapay zeka sistemlerinin veri toplama süreçlerinin birbirinden ayrılması gerektiğini söyledi.
Açık erişimli bir çalışmada araştırmacının eserin tamamına ulaşabildiğini ve yazara atıf yapabildiğini ifade eden Argun, yapay zeka sistemlerinde ise çok sayıda kaynaktan alınan içeriklerin bir araya getirilmesi nedeniyle bilginin kaynağının kullanıcı açısından her zaman belirgin olmayabileceğini dile getirdi.
Argun'a göre akademik eserlerin üretiminde yazar, editör, hakem ve yayıncının katkıları bulunuyor. Bu içeriklerin yapay zeka sistemlerinin eğitiminde kullanılmasının, katkı sahiplerinin haklarının nasıl korunacağı sorusunu da beraberinde getirdiğini belirtti.
Çeviri Veri Tabanları Da Talep Ediliyor
Yapay zeka şirketlerinin ilgisinin yalnızca Türkçe kitaplarla sınırlı olmadığını belirten Argun, yayınevlerinin yıllar içinde oluşturduğu çeviri veri tabanlarının da talep edildiğini aktardı.
Argun, yaklaşık üç yıl önce yayınevinin işbirliği yaptığı yabancı bir kuruluşun Türkçeye çevrilen kitaplara ilişkin verileri yapay zeka sistemini geliştirmek amacıyla talep ettiğini söyledi. Bu içerikler karşılığında ödeme yapılmasının teklif edildiğini belirten Argun, daha sonra söz konusu girişimden vazgeçildiğini ifade etti.
Talep edilen çeviri verilerinin, yabancı yayınevlerinin ellerindeki eserleri farklı dillere daha hızlı çevirmesine ve dijital ortamda yayımlamasına yönelik çalışmalarda kullanılmasının amaçlanmış olabileceğini değerlendiren Argun, çeviri veri tabanlarının da telif ve kullanım hakkı açısından ele alınması gerektiğini kaydetti.
Yayıncılar İçin Telif Ve Veri Güvenliği Gündemde
Yapay zeka sistemlerinin eğitiminde telifli eserlerin kullanılması, dünya genelinde teknoloji şirketleri ile yazar ve yayıncılar arasında tartışma konusu olmaya devam ediyor. Türkiye'de de kitapların, akademik çalışmaların ve çeviri veri tabanlarının hangi şartlarda yapay zeka sistemlerine aktarılabileceği sorusu yayıncılık sektörünün gündeminde bulunuyor.
Argun, mevcut telif sözleşmeleri ve mevzuatın yapay zeka teknolojilerindeki hızlı gelişmelere tam olarak uyum sağlayamadığını savundu. Yapay zeka kullanımının önüne geçilmesinden ziyade eser sahiplerinin haklarını koruyacak bir sistem oluşturulması gerektiğini belirtti.
Yapay Zeka Gelirinden Eser Sahiplerine Pay Önerisi
Argun, yapay zeka modellerinin eğitiminde kullanılan eserlerin sahipleri için kullanım oranına dayalı bir gelir paylaşım sistemi kurulmasını önerdi.
Örneğin 100 bin kitaptan oluşan bir veri tabanının yapay zeka sisteminin eğitiminde kullanılması halinde, modelin ürettiği yanıtlar ve içeriklerdeki kullanım oranları üzerinden eser sahipleri ile yayıncılara pay aktarılabileceğini belirten Argun, bunun dijital video ve arama motorlarında kullanılan gelir paylaşım modellerine benzer şekilde tasarlanabileceğini söyledi.
Yapay zeka teknolojilerinin gelişiminin devam edeceğini ifade eden Argun, bu süreçte kitap ve akademik yayınların üretiminde katkısı bulunan yazar, çevirmen ve yayıncıların haklarının korunacağı bir telif mekanizmasının oluşturulması gerektiğini kaydetti.